Triển khai Cluster + Ceph + HA
Từ 4 node Proxmox rời rạc thành một cụm HA hoàn chỉnh: corosync cluster, Ceph Tentacle 20.2 với MON/MGR/OSD, pool vm-ceph replication 3, watchdog softdog và HA rules để VM tự migrate khi node chết.
Quorum & điều kiện triển khai
Vì sao cần số node lẻ · QDevice cho 2 node · Checklist trước khi bắt đầu
Quorum theo số node
| Cấu hình | Mất 1 node | Mất 2 node | HA hoạt động? |
|---|---|---|---|
| 4 node (lab này) | 3/4 phiếu — quorum OK | 2/4 phiếu — mất quorum (cần > 2/4, tức tối thiểu 3 phiếu) | ⚠️ Chịu được 1 node chết; mất 2 node thì cụm chuyển read-only |
| 3 node | 2/3 phiếu — quorum OK | 1/3 — mất quorum | ⚠️ Chỉ chịu được 1 node chết |
| 2 node | 1/2 = 50% — mất quorum | — | ❌ Không, cần QDevice |
/etc/pve sang chế độ chỉ đọc. Đây là cơ chế bảo vệ dữ liệu, không phải lỗi — nếu hai nửa cụm cùng ghi sẽ hỏng dữ liệu vĩnh viễn.
Điều kiện cần & đủ cho Ceph + HA
Phải đáp ứng TẤT CẢ trước khi bắt đầu:
- PVE cluster: ≥ 3 node đã join (
pvecm status→ Quorum OK, Votes ≥ 3) - Ceph OSDs: ≥ 3 OSD trên ≥ 3 host vật lý riêng biệt (để replication=3 hoạt động)
- RAM mỗi node: ≥ 4 GB dành riêng cho Ceph (khuyến nghị 8 GB+ nếu nhiều OSD)
- Disk OSD: raw block device sạch — không partition / filesystem / LVM
- Network: ít nhất 1 NIC cho Ceph public/cluster network (lab:
10.11.45.0/24) - OS: Proxmox VE 9 / Debian 13 Trixie — Ceph Tentacle 20.2 yêu cầu trixie trở lên
vm-ceph ≈ 380 GiB) lấy từ lab mẫu 4 OSD × ~300 GiB. Phần cứng của series là 800 GB SSD + 1 TB HDD, thin provisioning, hai tầng Ceph: 4 node × 200 GB SSD (/dev/sdb, OSD ở mục 5.7, pool vm-ceph, ≈ 745 GiB raw, usable ≈ 248 GiB, vùng an toàn ≈ 149 GiB) và 4 node × 250 GB HDD (/dev/sdc, OSD thêm ở mục 7.6, pool vm-bulk, ≈ 931 GiB raw). Số trong khối lệnh và ghi chú đã tính theo phần cứng này; số trong ảnh giữ nguyên và có nhãn Lab mẫu. Đĩa của bạn khác thì thay vào công thức ở bài 07 mục 8.4. Phần "Bài toán thực tế: chọn storage" ở cuối bài là kịch bản mua phần cứng riêng (3 server, 10 VM), không phải đĩa của lab.
Cấu hình /etc/hosts và network
Phân giải tên nội bộ · Bridge vmbr0 VLAN-aware · Áp dụng không cần reboot
1.1 Thêm hostname resolution vào /etc/hosts
# ── Thêm hostname resolution vào /etc/hosts ────────────────
cat >> /etc/hosts << 'EOF'
10.11.45.210  node1  node1.hoatranlabs.local
10.11.45.211  node2  node2.hoatranlabs.local
10.11.45.212  node3  node3.hoatranlabs.local
10.11.45.213  node4  node4.hoatranlabs.local
EOF

# ── Kiểm tra từ node1 ──────────────────────────────────────
ping -c 2 node2          # phải trả về 10.11.45.211
ping -c 2 node3          # phải trả về 10.11.45.212
ping -c 2 node4          # phải trả về 10.11.45.213

# ── Kiểm tra từ node2 ──────────────────────────────────────
ping -c 2 node1          # phải trả về 10.11.45.210
ping -c 2 node3          # phải trả về 10.11.45.212
ping -c 2 node4 # phải trả về 10.11.45.21310.11.45.213 node3 node4.hoatranlabs.local — tên ngắn là node3 thay vì node4. Hai dòng cùng tên node3 làm ping node4 thất bại và corosync định danh sai node. Chạy getent hosts node4 để xác nhận trước khi đi tiếp.
1.2 Ghi file /etc/network/interfaces
Làm trên node1 trước, rồi lặp lại cho node2/3/4 — chỉ đổi dòng address theo IP của từng node.
# ── Ghi file /etc/network/interfaces ───────────────────────
cat > /etc/network/interfaces << 'EOF'
auto lo
iface lo inet loopback

# Uplink vật lý — không cần auto stanza, bridge tự bring up
iface nic0 inet manual

# Bridge duy nhất — VLAN-aware, mang tất cả VLAN
auto vmbr0
iface vmbr0 inet static
    address  10.11.45.210/24
    gateway  10.11.45.1
    dns-nameservers 8.8.8.8
    bridge-ports    nic0
    bridge-stp      off
    bridge-fd       0
    bridge-vlan-aware yes
    bridge-vids     25 35 45 55 65 75 85
EOF

# ── Áp dụng không cần reboot ───────────────────────────────
ifreload -a

# ── Kiểm tra bridge đã nhận VLAN IDs ───────────────────────
bridge vlan show dev vmbr0
# Phải thấy: 25, 35, 45, 55, 65, 75, 85 trong cột VLAN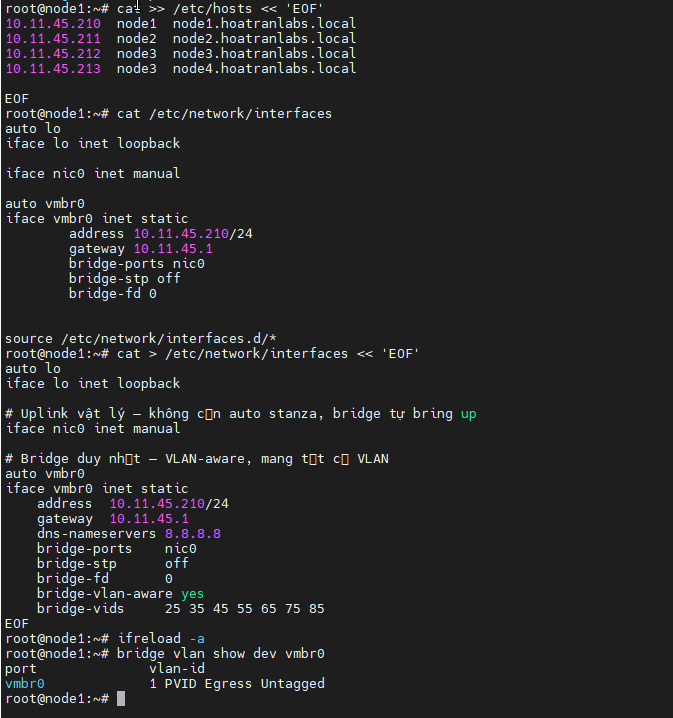
/etc/hosts → ghi /etc/network/interfaces với bridge-vlan-aware yes → ifreload -a → bridge vlan show dev vmbr0.
bridge vlan show mới chỉ hiện 1 PVID Egress Untagged — chưa thấy 25…85. Nếu gặp tình trạng này, kiểm tra ifreload -a có báo lỗi không, hoặc chạy systemctl restart networking. VLAN chỉ thật sự cần khi gắn VM vào VLAN tag — cluster và Ceph trong bài này chạy trên VLAN mặc định nên không chặn các bước sau.
Tạo Cluster trên node1
Datacenter › Cluster › Create Cluster · Ring 0 Address
- Mở WebUI node1:
https://10.11.45.210:8006→ đăng nhậproot - Vào Datacenter › Cluster › Create Cluster
- Cluster Name:
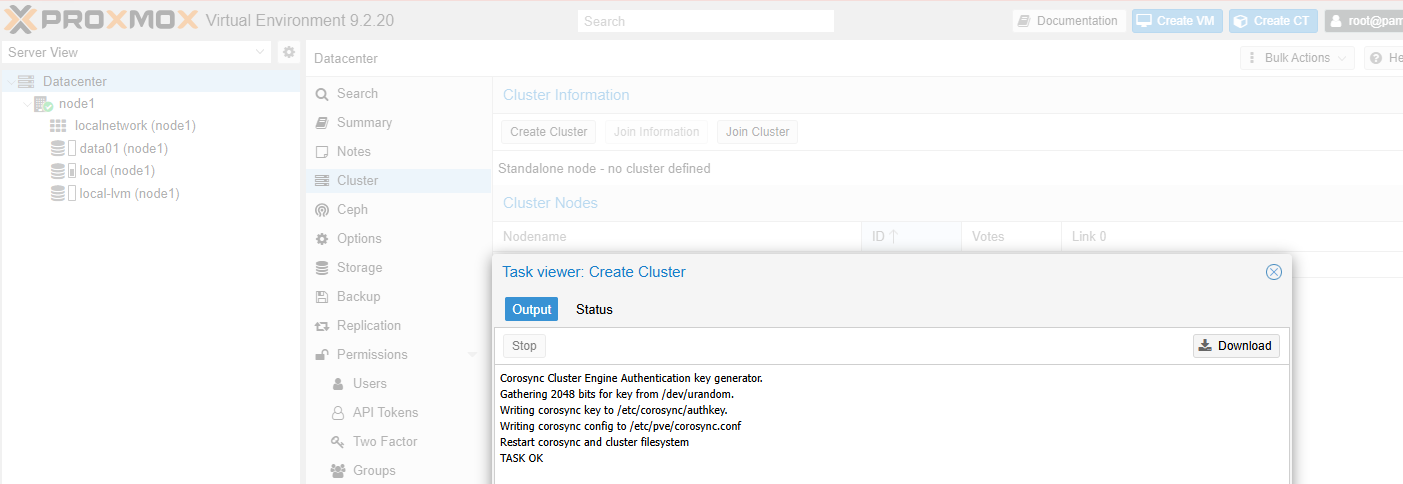
HOATRANHUB· Link 0:10.11.45.210(tự động điền) - Click Create → chờ task "Create cluster" hoàn tất
- Verify: Datacenter › Cluster → hiện
HOATRANHUB, Node count: 1, Quorum: OK
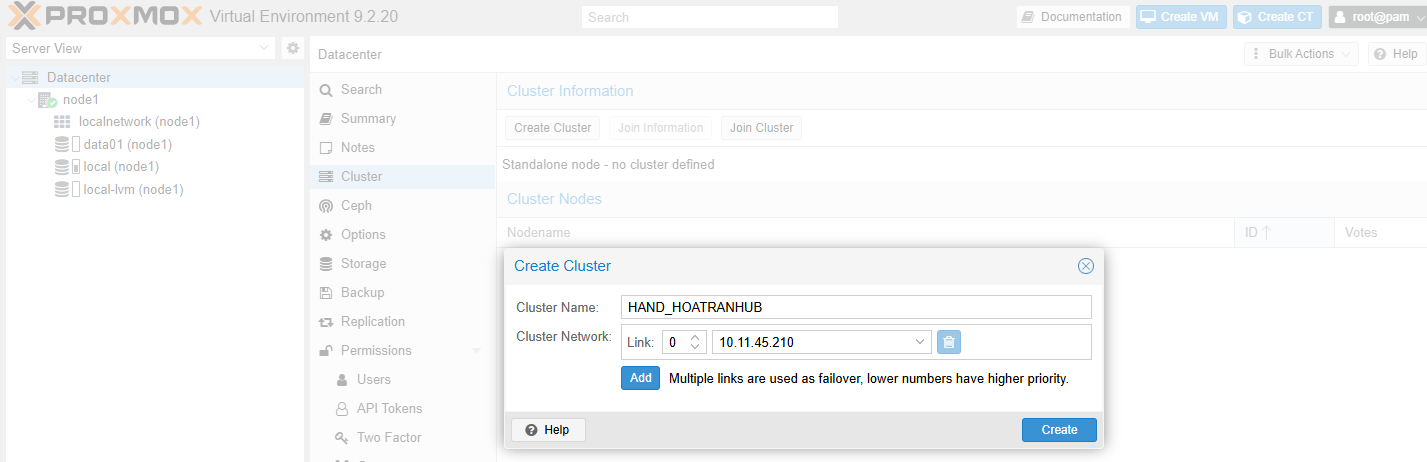
10.11.45.210. Ảnh chụp lúc đang gõ tên; tên chốt cuối cùng trong lab là HOATRANHUB.
Join node2 · node3 · node4 vào cluster
Copy Join Information · Assisted join · Verify 4 votes · Rolling restart corosync
3.1 Lấy Join Information từ node1
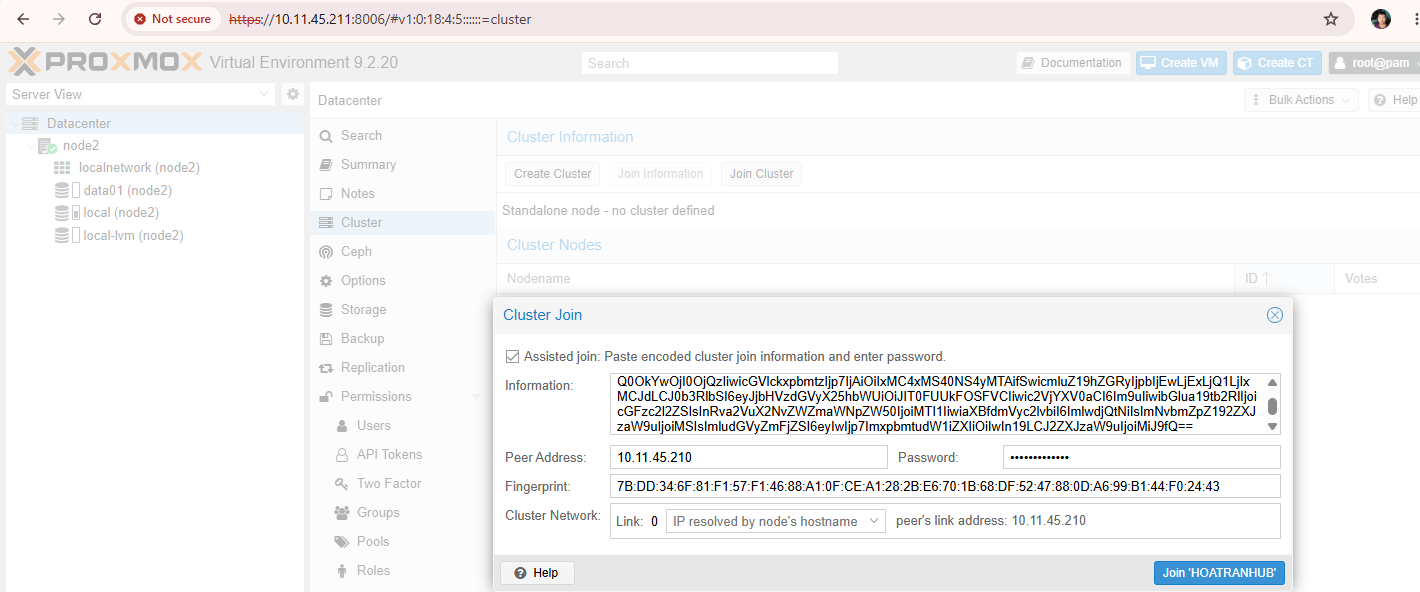
Trên node1: Datacenter › Cluster › Join Information → bấm Copy Information.
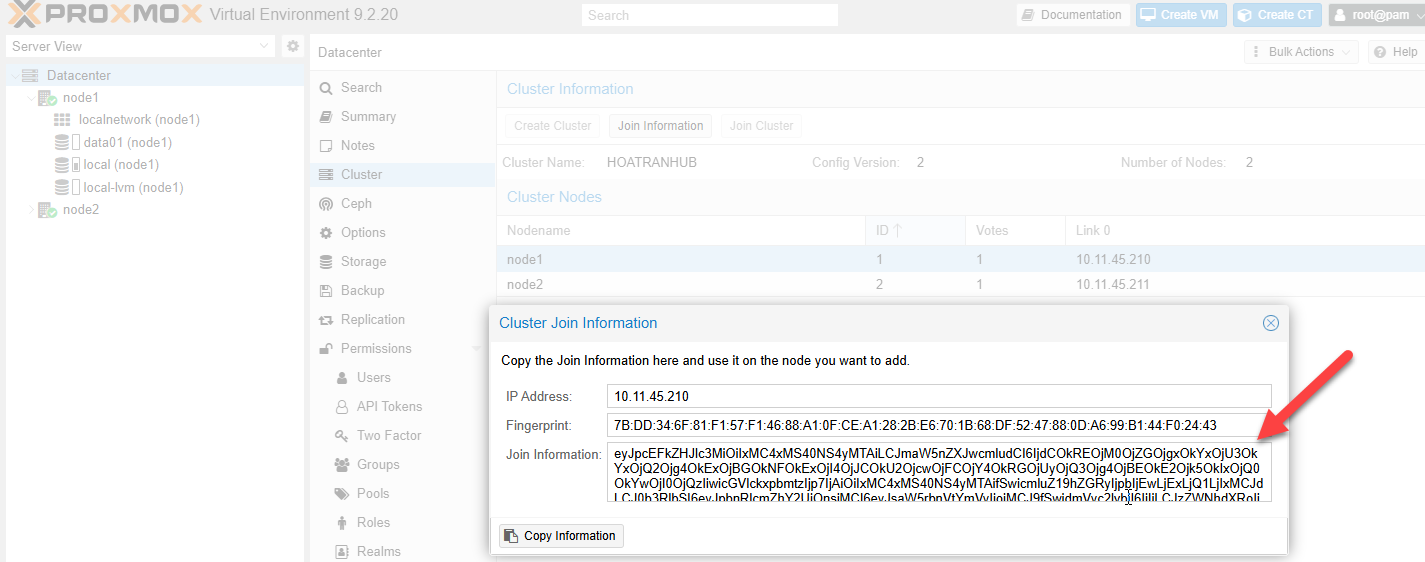
10.11.45.210, Fingerprint và chuỗi base64 chứa toàn bộ thông tin join. Bấm Copy Information.
3.2 Join từ node2 (lặp lại cho node3, node4)
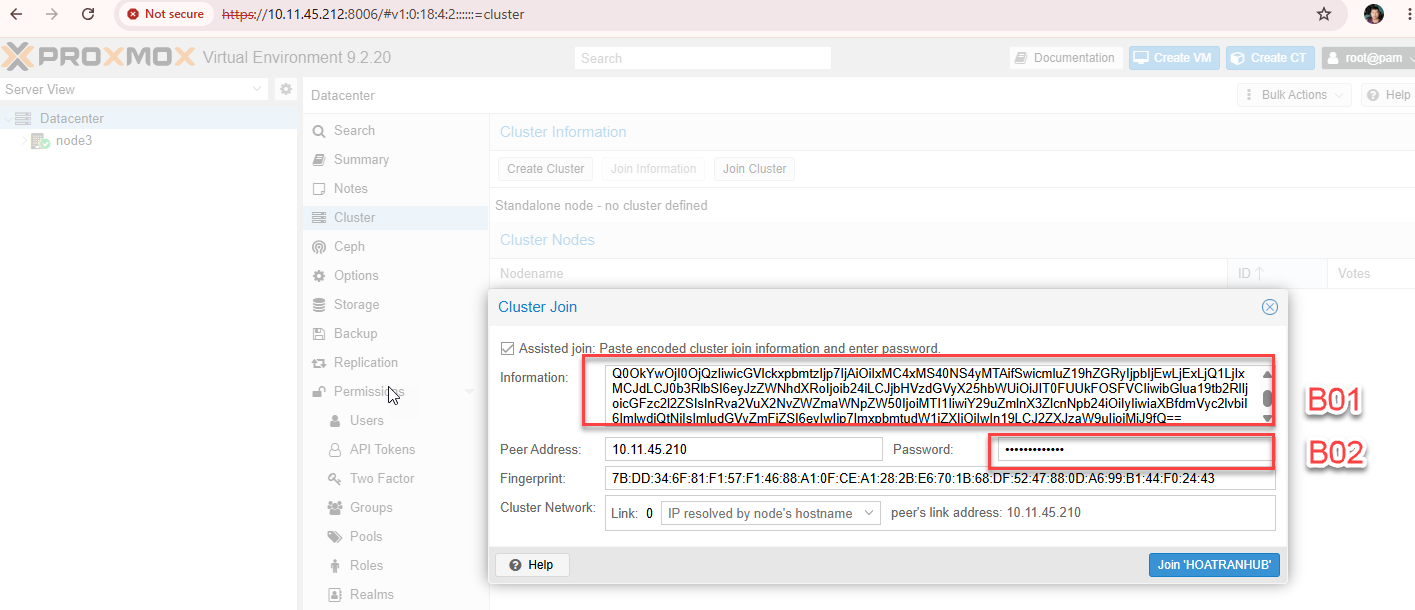
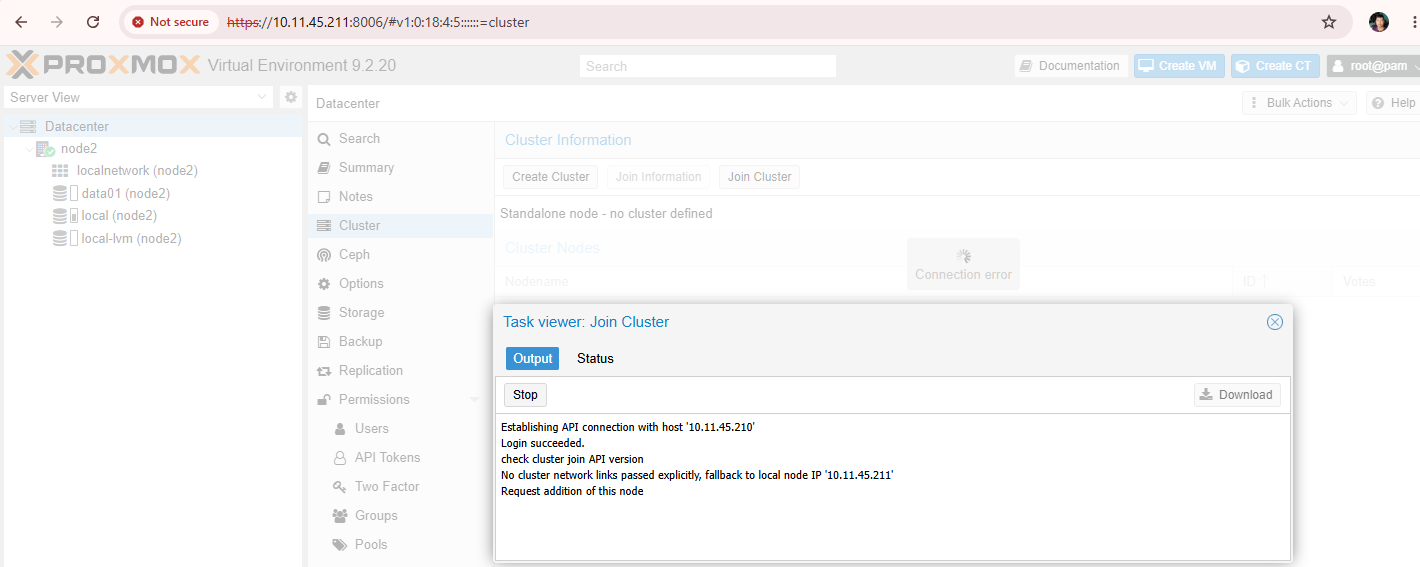
Mở WebUI node cần join → Datacenter › Cluster › Join Cluster → dán chuỗi vào ô Information → nhập Password của root node1 → bấm Join 'HOATRANHUB'.
3.3 Verify từ CLI
# SSH vào node bất kỳ
pvecm status
pvecm nodes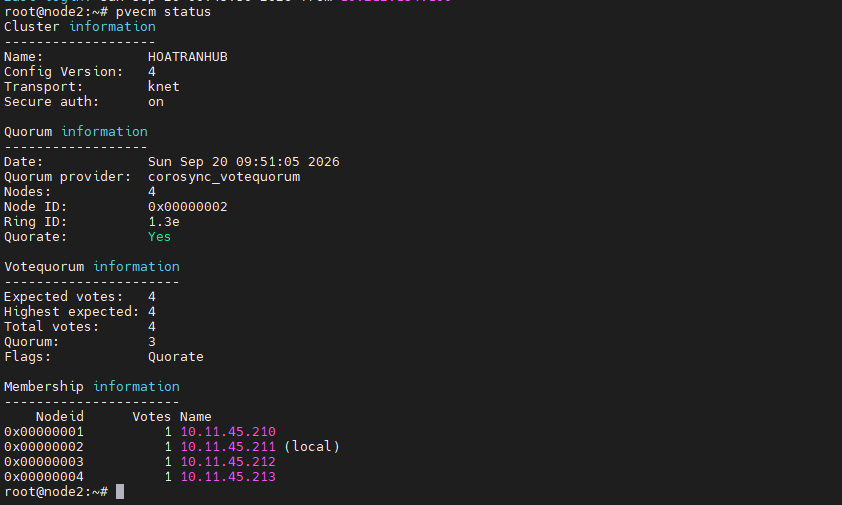
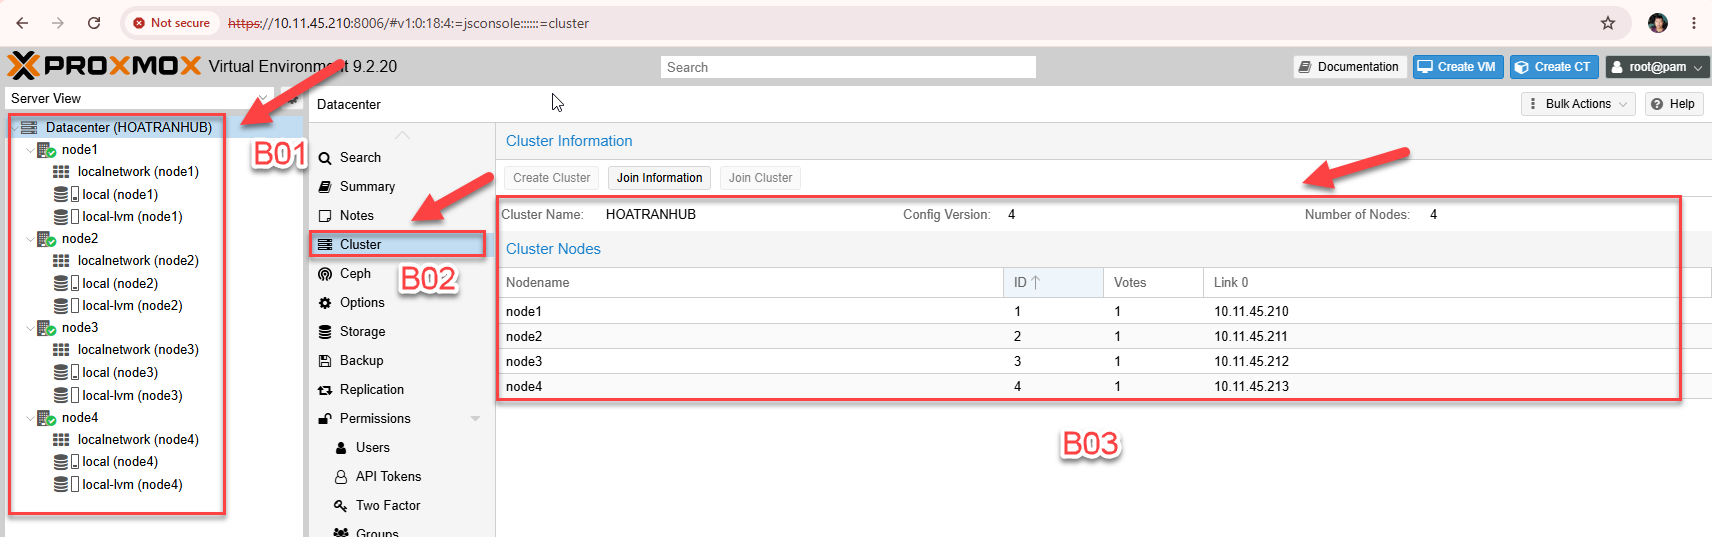
pvecm status chạy từ node2 — Name HOATRANHUB, Nodes 4, Quorate: Yes, Expected votes 4, Total votes 4, Quorum 3, membership đủ .210 → .213.
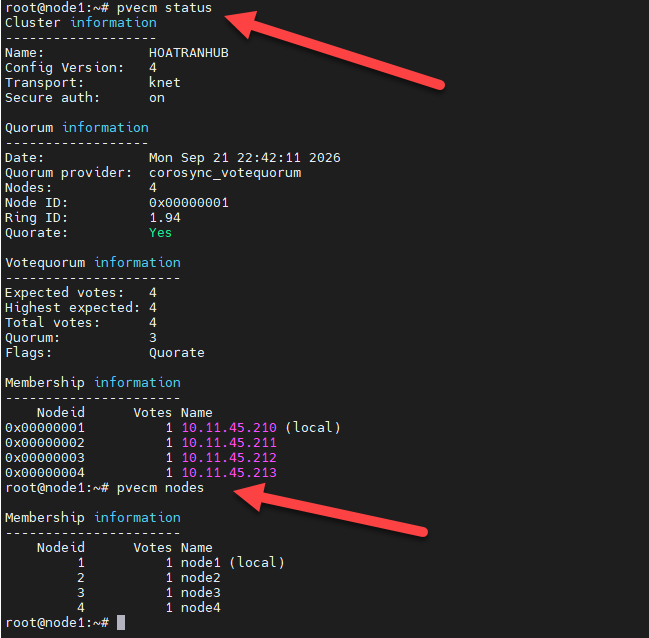
pvecm nodes — bảng membership hiện đủ tên node1 … node4, xác nhận phân giải hostname hoạt động đúng.
3.4 Rolling restart corosync
pvecm status hiện đủ 4/4 votes rồi mới sang node tiếp theo. Restart cùng lúc = mất quorum toàn cụm.
# ── BƯỚC 1: Restart node4 trước ────────────────────────────
#    Chạy trên node4:
systemctl restart corosync pve-cluster
#    Chạy trên node1 — chờ node4 online lại:
pvecm status       # phải thấy 4/4 votes trước khi tiếp tục

# ── BƯỚC 2: Restart node3 ──────────────────────────────────
#    Chạy trên node3:
systemctl restart corosync pve-cluster
pvecm status       # chờ 4/4 votes

# ── BƯỚC 3: Restart node2 ──────────────────────────────────
#    Chạy trên node2:
systemctl restart corosync pve-cluster
pvecm status       # chờ 4/4 votes

# ── BƯỚC 4: Restart node1 cuối cùng ────────────────────────
#    Chạy trên node1:
systemctl restart corosync pve-cluster

#    Kiểm tra từ bất kỳ node nào:
pvecm status # Expected: 4, Total: 4, Quorum: 3Cài Ceph Tentacle 20.2 trên cả 4 node
Dọn repo cũ · Thêm ceph-tentacle no-subscription · Cài package · Verify version
download.proxmox.com/debian/ceph-tentacle suite trixie. Bài này dùng Tentacle nhất quán theo ảnh chụp thực tế.
4.1 Script cài đặt đầy đủ
Mở 4 terminal SSH và chạy đồng thời trên cả 4 node — bước này có thể làm song song vì chưa đụng tới cluster state.
set -e

echo "===== 1. Backup APT repo configuration ====="
BACKUP_DIR="/root/apt-repo-backup-$(date +%F-%H%M%S)"
mkdir -p "$BACKUP_DIR"
cp -a /etc/apt/sources.list /etc/apt/sources.list.d "$BACKUP_DIR/" 2>/dev/null || true
echo "Backup: $BACKUP_DIR"

echo "===== 2. Remove duplicate PVE no-subscription source ====="
# Giữ file deb822 mới; disable file legacy .list trùng lặp để bỏ warning.
if [ -f /etc/apt/sources.list.d/pve-no-subscription.list ]; then
    mv -v \
      /etc/apt/sources.list.d/pve-no-subscription.list \
      /etc/apt/sources.list.d/pve-no-subscription.list.disabled
fi

echo "===== 3. Disable all old/conflicting Ceph repository definitions ====="
mkdir -p /root/disabled-apt-repos

find /etc/apt/sources.list.d -maxdepth 1 -type f \
  \( -iname 'ceph*.list' -o -iname 'ceph*.sources' -o -iname '*squid*.list' -o -iname '*squid*.sources' -o -iname '*tentacle*.list' -o -iname '*tentacle*.sources' \) \
  -exec mv -v {} /root/disabled-apt-repos/ \;

echo "===== 4. Disable Ceph enterprise repo if it exists elsewhere ====="
# Không có subscription thì enterprise trả HTTP 401.
grep -RIl 'enterprise.proxmox.com/debian/ceph' \
  /etc/apt/sources.list \
  /etc/apt/sources.list.d 2>/dev/null \
| while IFS= read -r file; do
    case "$file" in
        /etc/apt/sources.list.d/*)
            mv -v "$file" "/root/disabled-apt-repos/$(basename "$file").enterprise-disabled"
            ;;
        /etc/apt/sources.list)
            cp -a /etc/apt/sources.list "$BACKUP_DIR/sources.list.before-ceph-enterprise-disable"
            sed -i '\|enterprise\.proxmox\.com/debian/ceph|d' /etc/apt/sources.list
            ;;
    esac
done

echo "===== 5. Create the sole Ceph Tentacle no-subscription source ====="
cat > /etc/apt/sources.list.d/ceph.sources <<'EOF'
Types: deb
URIs: http://download.proxmox.com/debian/ceph-tentacle
Suites: trixie
Components: no-subscription
Signed-By: /usr/share/keyrings/proxmox-archive-keyring.gpg
EOF

echo "===== 6. Refresh package indexes ====="
rm -rf /var/lib/apt/lists/*
mkdir -p /var/lib/apt/lists/partial
apt-get update

echo "===== 7. Confirm Ceph Tentacle is selected ====="
apt-cache policy \
  ceph-common ceph-fuse ceph-base ceph-osd ceph-mon ceph-mgr \
  librbd1 librados2 libcephfs2 libradosstriper1 librgw2 \
  python3-cephfs python3-ceph-argparse python3-ceph-common \
  python3-rados python3-rbd python3-rgw

echo "===== 8. Repair interrupted package state ====="
dpkg --configure -a
apt-get -f install -y

echo "===== 9. Install Ceph Tentacle services and dependencies ====="
apt-get install -y \
  ceph ceph-base ceph-common ceph-fuse \
  ceph-mon ceph-mgr ceph-mgr-modules-core \
  ceph-osd ceph-volume \
  python3-pecan python3-werkzeug

echo "===== 10. Verify installed versions ====="
ceph --version
ceph-osd --version
ceph-mon --version
ceph-mgr --version

echo "===== COMPLETE ====="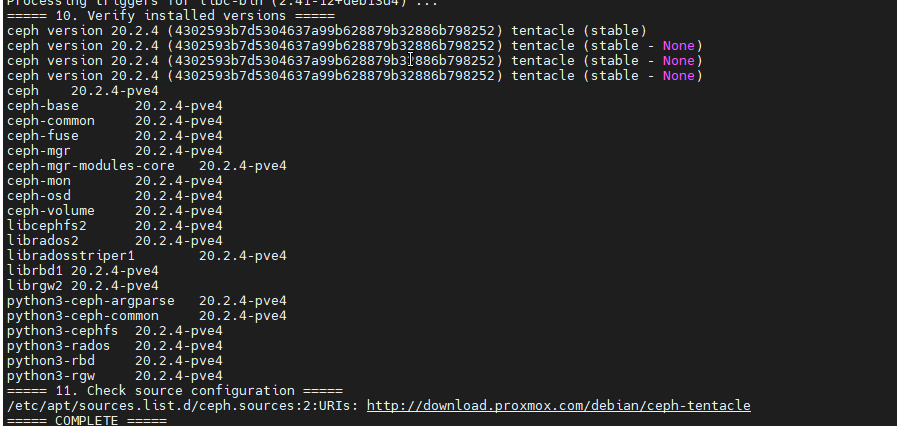
ceph version 20.2.4 … tentacle (stable), toàn bộ package ở bản 20.2.4-pve4, source trỏ đúng download.proxmox.com/debian/ceph-tentacle.
| Vấn đề | Hậu quả nếu bỏ qua |
|---|---|
Trùng .list và .sources | apt cảnh báo duplicate, khó đọc log khi gỡ lỗi |
| Còn repo Squid/Reef cũ | apt trộn phiên bản, cài nhầm bản không khớp giữa các node |
| Repo enterprise còn bật | apt update trả HTTP 401, dừng toàn bộ quá trình |
| Version lệch giữa các node | OSD/MON không join được cluster, health WARN kéo dài |
Khởi tạo Ceph: MON · MGR · OSD
pveceph init · Fix bug mon_host · MGR standby · OSD trên /dev/sdb
5.0 Ba thành phần cốt lõi
"Trọng tài" của cluster. Giữ cluster map (ai là node, OSD nào up/down, data ở đâu). Mọi client hỏi MON trước khi làm gì. Cần số lẻ (1, 3, 5) để bầu cử đa số — mất 1 trong 3 MON, 2 còn lại vẫn chạy.
"Thư ký" của cluster. Cung cấp dashboard, REST API, metrics, plugin (alert, balancer, telemetry). Không ảnh hưởng IO — cluster vẫn đọc/ghi khi MGR down. Cần ≥1 active + 1 standby cho HA.
"Kho chứa" thực sự. Mỗi disk = 1 OSD. OSD lưu data, tự nhân bản sang OSD khác (replication=3 → 1 block ghi lên 3 OSD), tự phục hồi khi có OSD lỗi. Cần ≥3 OSD trên ≥3 host khác nhau.
Client → hỏi MON: "data này ở đâu?"
       → MON trả về map: "OSD 0, 1, 2"
       → Client ghi thẳng vào OSD 0, 1, 2 (bỏ qua MON)
MGR    → đứng ngoài quan sát, báo cáo trạng thái
5.1 Init cluster Ceph (CHỈ trên node1)
Tạo cluster ID và /etc/pve/ceph.conf với network Ceph. Node1 là bootstrap — cluster "sinh ra" ở đây.
pveceph init --network 10.11.45.0/24
pveceph init báo creating /etc/pve/priv/ceph.client.admin.keyring — cluster Ceph đã được khởi tạo.
5.2 Tạo MON đầu tiên + fix mon_host
pveceph init KHÔNG tự thêm mon_host → ceph -s báo "cannot identify monitors". Phải fix NGAY sau pveceph mon create.
pveceph mon create

# Fix mon_host ngay lập tức:
grep -q 'mon_host' /etc/pve/ceph.conf || \
    sed -i '/^\[global\]/a\\tmon_host = 10.11.45.210' /etc/pve/ceph.conf

# Verify (sau 10 giây):
sleep 10 && ceph -s
# → phải thấy: mon: 1 daemons, quorum node1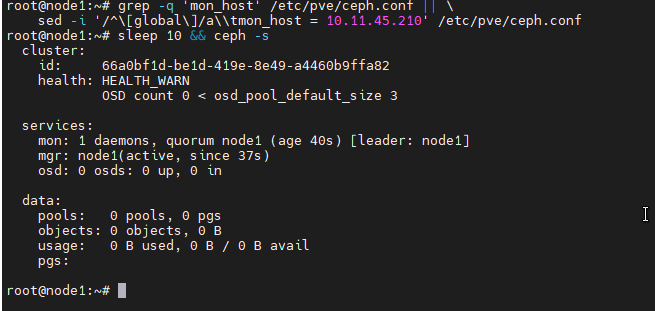
ceph -s đã kết nối được: mon: 1 daemons, quorum node1, mgr: node1(active). HEALTH_WARN "OSD count 0 < osd_pool_default_size 3" là bình thường vì chưa có OSD.
5.3 Dọn cảnh báo bảo mật
# Bật giao thức mã hóa msgr2
ceph mon enable-msgr2

# Tắt lỗ hổng global_id reclaim cũ
ceph config set mon auth_allow_insecure_global_id_reclaim false

ceph health detail
# → HEALTH_OK (hoặc WARN "OSD count 0" — bình thường khi chưa có OSD)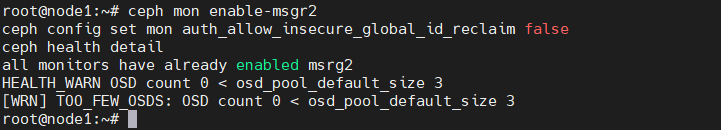
ceph health detail — hai cảnh báo bảo mật đã biến mất, chỉ còn cảnh báo thiếu OSD.
5.4 Tạo MGR trên node1
pveceph mgr create lỗi "No such file or directory" nếu /var/lib/ceph/mgr/ chưa tồn tại. Phải mkdir trước.
mkdir -p /var/lib/ceph/mgr && chown ceph:ceph /var/lib/ceph/mgr
pveceph mgr create
sleep 10
ceph mgr stat
# → active_name: node1, num_standby: 0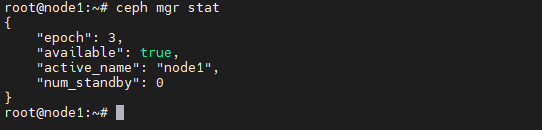
active_name: node1.
5.5 Thêm MON trên node2, node3, node4
# Chạy trên node2:
pveceph mon create

# Chạy trên node3:
pveceph mon create

# Chạy trên node4:
pveceph mon create

# Verify từ node1 (sau ~30 giây):
ceph mon stat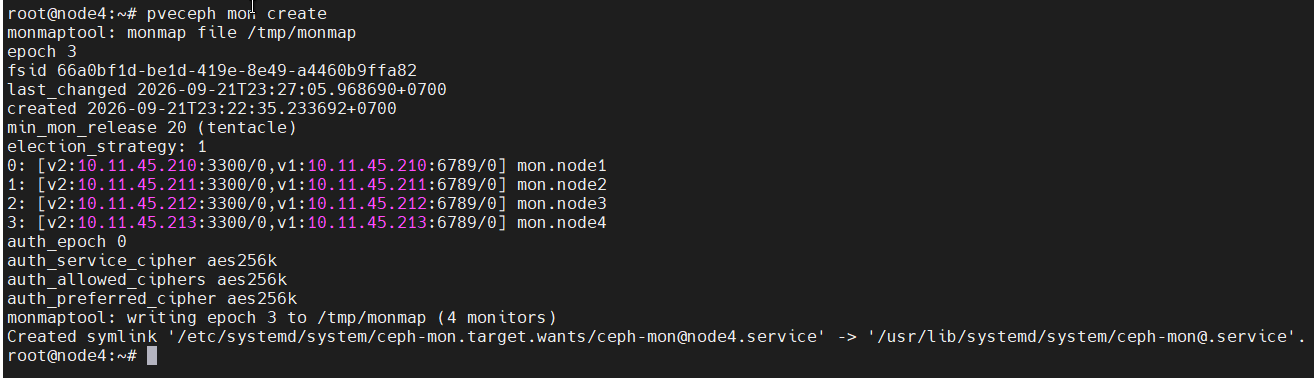

ceph mon stat — 4 mons tại node1…node4 (mỗi MON lắng nghe v2:3300 và v1:6789), election epoch 16, leader node1, quorum 0,1,2,3.
5.6 Thêm MGR standby trên node2
Nếu node1 down, MGR tự failover sang node2. Không bắt buộc nhưng cần cho HA thực sự.
# Chạy trên node2:
mkdir -p /var/lib/ceph/mgr && chown ceph:ceph /var/lib/ceph/mgr
pveceph mgr create

# Verify từ node1:
ceph mgr stat
# → active_name: node1, num_standby: 1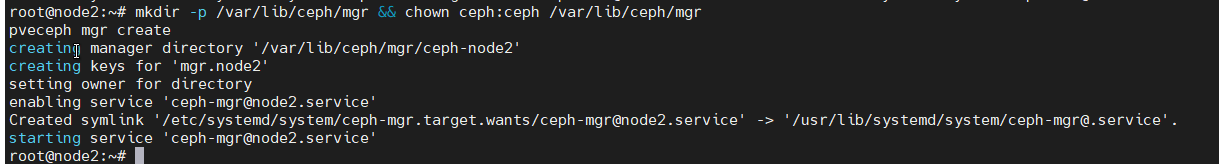
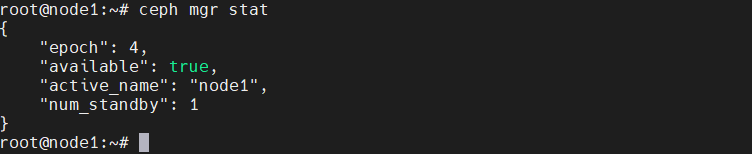
"active_name": "node1", "num_standby": 1 — MGR đã có dự phòng.
5.7 Tạo OSD trên cả 4 node
/dev/sdb — kiểm tra kỹ đúng disk trước khi chạy.
# Chạy lần lượt trên node1, node2, node3, node4 (khai class ssd tường minh, đừng để Ceph tự đoán):
pveceph osd create /dev/sdb --crush-device-class ssd

# Verify từ node1 sau khi xong tất cả:
ceph osd tree
# → 4 host, mỗi host 1 OSD (osd.0/1/2/3), STATUS = "up", CLASS = ssd
ceph osd crush class ls
# → [ "ssd" ]   (thấy "hdd": đĩa bị nhận sai class, xem lưu ý bên dưới)

ceph status
# → osd: 4 osds: 4 up, 4 in, ~745 GiB raw (4 × 200 GB SSD)--crush-device-class ssd (tham số của pveceph osd create) đặt nhãn class cho OSD ngay lúc tạo. Không khai thì Ceph tự đoán theo cờ rotational của ổ; SSD gắn qua máy ảo, RAID hoặc HBA thường bị nhận thành hdd (ảnh ceph osd tree mẫu bên dưới hiện class hdd). Class sai thì CRUSH rule rule-ssd/rule-hdd về sau chọn sai OSD, nên tạo xong hãy kiểm cột CLASS của ceph osd tree và danh sách ceph osd crush class ls. Nếu /dev/sdb của bạn là ổ quay thật thì đổi sang hdd. Rule rule-ssd/rule-hdd và pool vm-bulk làm ở bài 07 mục 8.5.
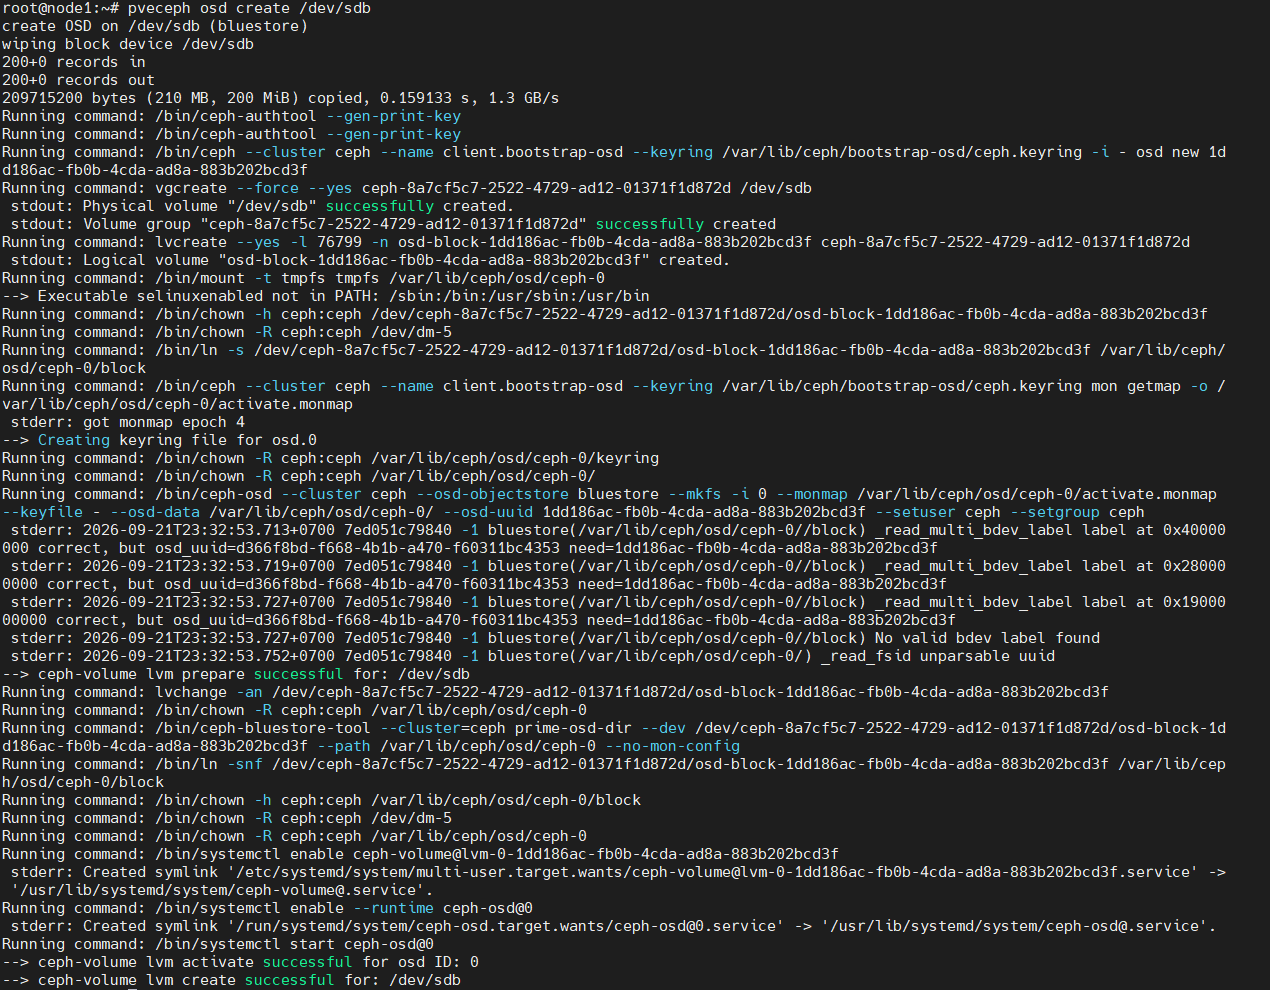
pveceph osd create /dev/sdb — wipe disk, tạo LVM volume group ceph-…, khởi tạo BlueStore, enable và start ceph-osd@0. Kết thúc bằng ceph-volume lvm create successful for: /dev/sdb.
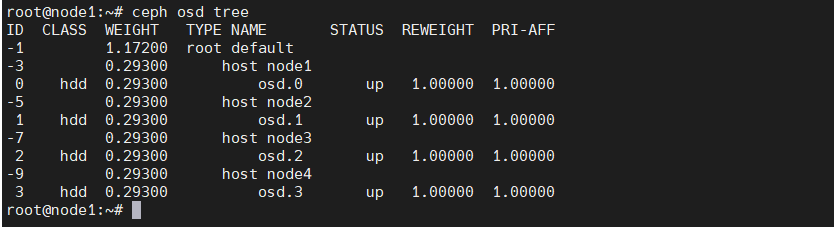
ceph osd tree — root default weight 1.17200, 4 host (node1…node4), mỗi host một OSD class hdd weight 0.29300, toàn bộ STATUS = up.
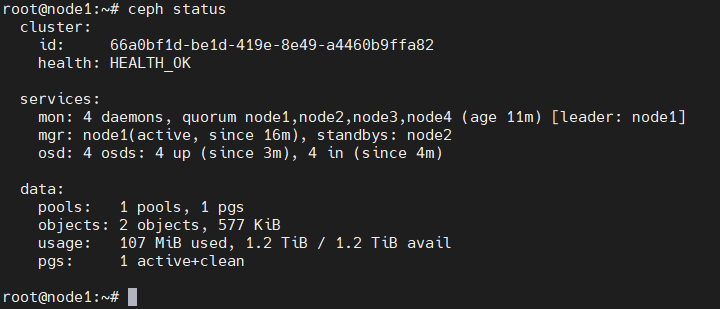
ceph status — HEALTH_OK, mon 4 daemons quorum node1…node4 [leader: node1], mgr node1(active) standbys node2, osd: 4 osds: 4 up, 4 in, usage 107 MiB / 1.2 TiB.
Tạo pool vm-ceph và đăng ký storage
size 3 / min_size 2 · PG autoscale · Tự thêm vào Proxmox storage
# Chạy trên node1
pveceph pool create vm-ceph --size 3 --min_size 2 \
--pg_autoscale_mode on --add_storages 1| Tham số | Giá trị | Ý nghĩa |
|---|---|---|
| vm-ceph | tên pool | Tên hiển thị trong Proxmox storage list |
| --size 3 | 3 bản sao | Mỗi block data ghi lên 3 OSD thuộc 3 node khác nhau → mất tối đa 2 node vẫn không mất dữ liệu (nhưng I/O có thể dừng, xem bên dưới) |
| --min_size 2 | tối thiểu 2 | Vẫn cho phép ghi khi chỉ còn 2 bản sao sống — mất 1 node thì IO không đứng |
| --pg_autoscale_mode on | tự điều chỉnh PG | PG (Placement Group) là đơn vị phân phối data. on = Ceph tự tính số PG tối ưu theo số OSD |
| --add_storages 1 | đăng ký vào PVE | Tự thêm pool vào Proxmox storage (pvesm) — VM chọn được vm-ceph làm disk ngay |
vm-ceph vừa tạo dùng rule mặc định (chọn mọi loại ổ; kiểm bằng ceph osd pool ls detail). Nếu cụm sẽ có thêm OSD HDD (mục 7.6), pool này phải gắn rule-ssd để dữ liệu VM không tràn lên HDD: tạo rule-ssd/rule-hdd rồi ceph osd pool set vm-ceph crush_rule rule-ssd (cả pool .mgr) trước khi thêm OSD HDD đầu tiên (bài 07 mục 8.5, bước 3 và 4). Lỡ thêm OSD HDD trước thì vẫn gắn rule-ssd ngay sau đó, nhưng Ceph phải chuyển dữ liệu VM đang nằm trên HDD về SSD (rebalance lớn, làm ngoài giờ). Cụm chỉ có SSD thì không cần.
Mất node thì sao?
size=3 trên 3 node còn lại → I/O hoạt động bình thường. Sau mon_osd_down_out_interval (mặc định 10 phút) Ceph tự dựng lại bản sao thứ 3 trên các node còn lại (rebalance); lúc đó mỗi OSD còn lại đầy lên khoảng 4/3, đó là lý do vùng an toàn của cụm chỉ ≈ 60% usable (bài 07 mục 8.4).min_size=2 → I/O của cụm Ceph dừng; dữ liệu chưa mất và hoạt động trở lại khi có node quay về (xem runbook ở bài 11).min_size → cụm Ceph ngừng phục vụ hoàn toàn (không đọc, không ghi) cho tới khi khôi phục đủ node.Verify
ceph status         # → HEALTH_OK
pvesm status        # → vm-ceph  rbd  active  ~235 GiB
ceph osd pool ls    # → .mgr, vm-ceph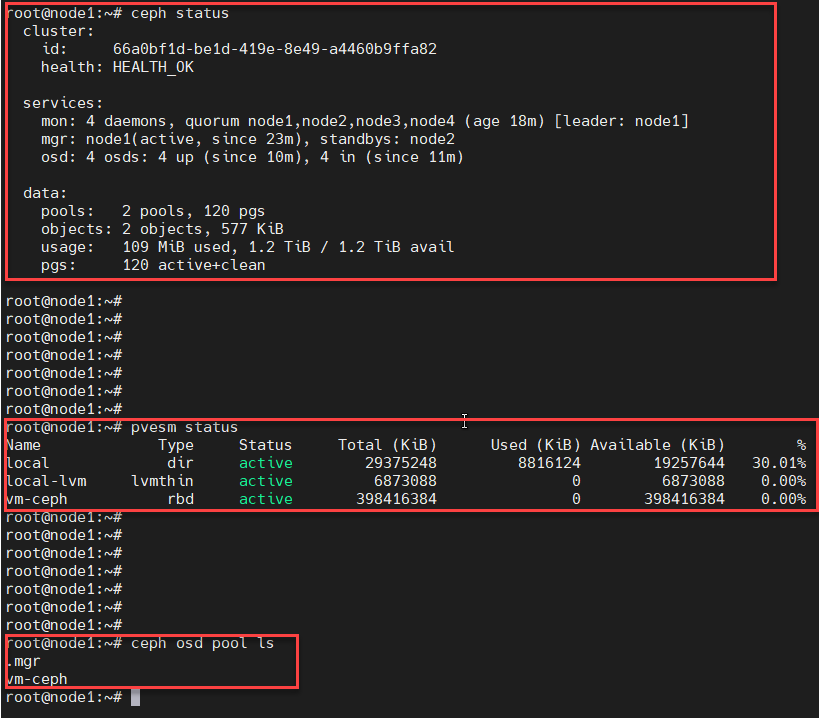
ceph status HEALTH_OK với 2 pools, 120 pgs active+clean; pvesm status hiện vm-ceph rbd active ~380 GiB khả dụng; ceph osd pool ls liệt kê .mgr và vm-ceph.
Kiểm tra qua GUI
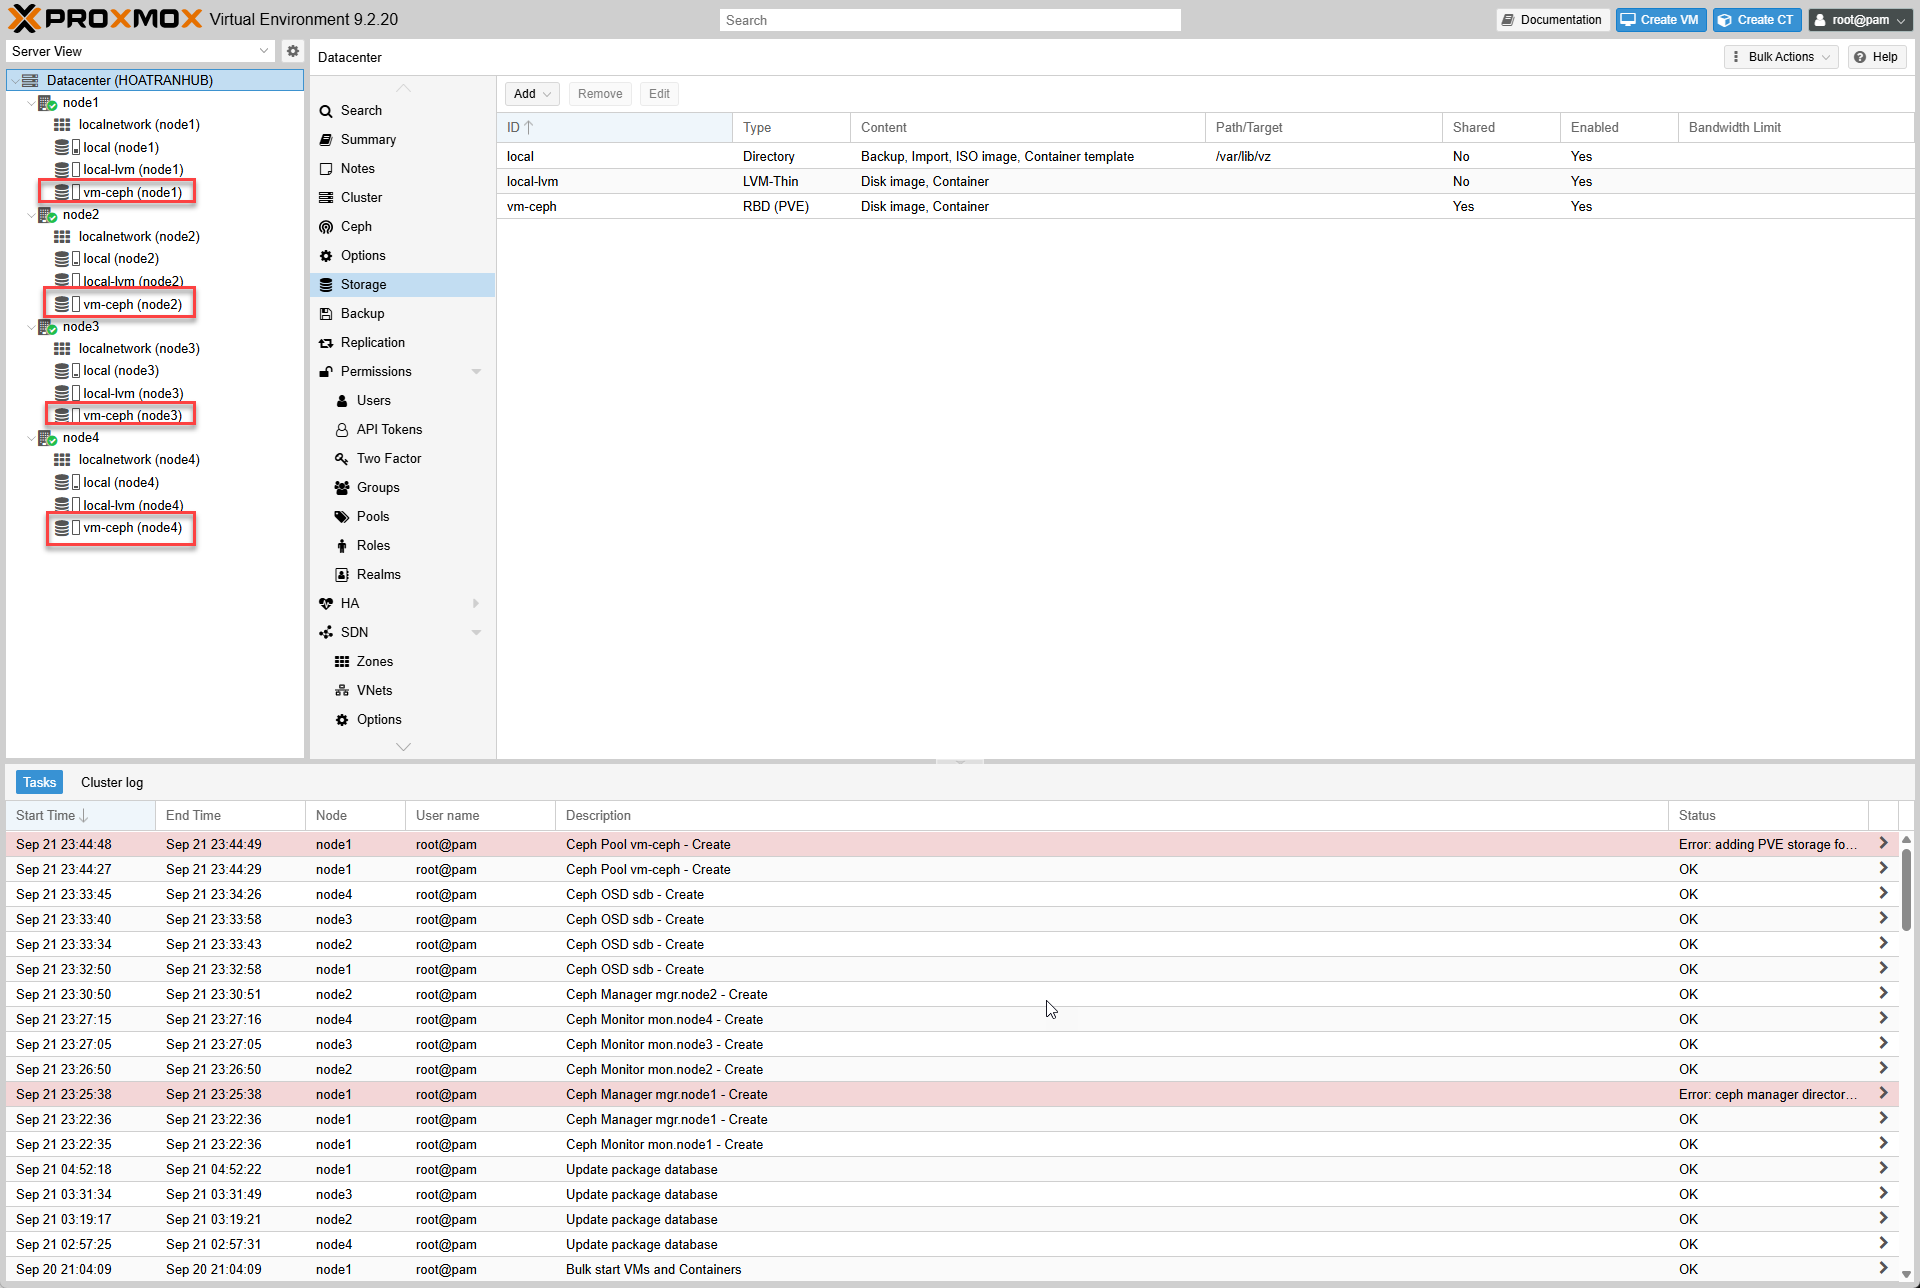
vm-ceph type RBD (PVE), Content "Disk image, Container", Shared = Yes. Server View hiện vm-ceph trên cả 4 node. Bảng Tasks bên dưới ghi lại đúng trình tự đã làm: mon.node1 → mgr.node1 → mon.node2/3/4 → mgr.node2 → 4 OSD → pool.
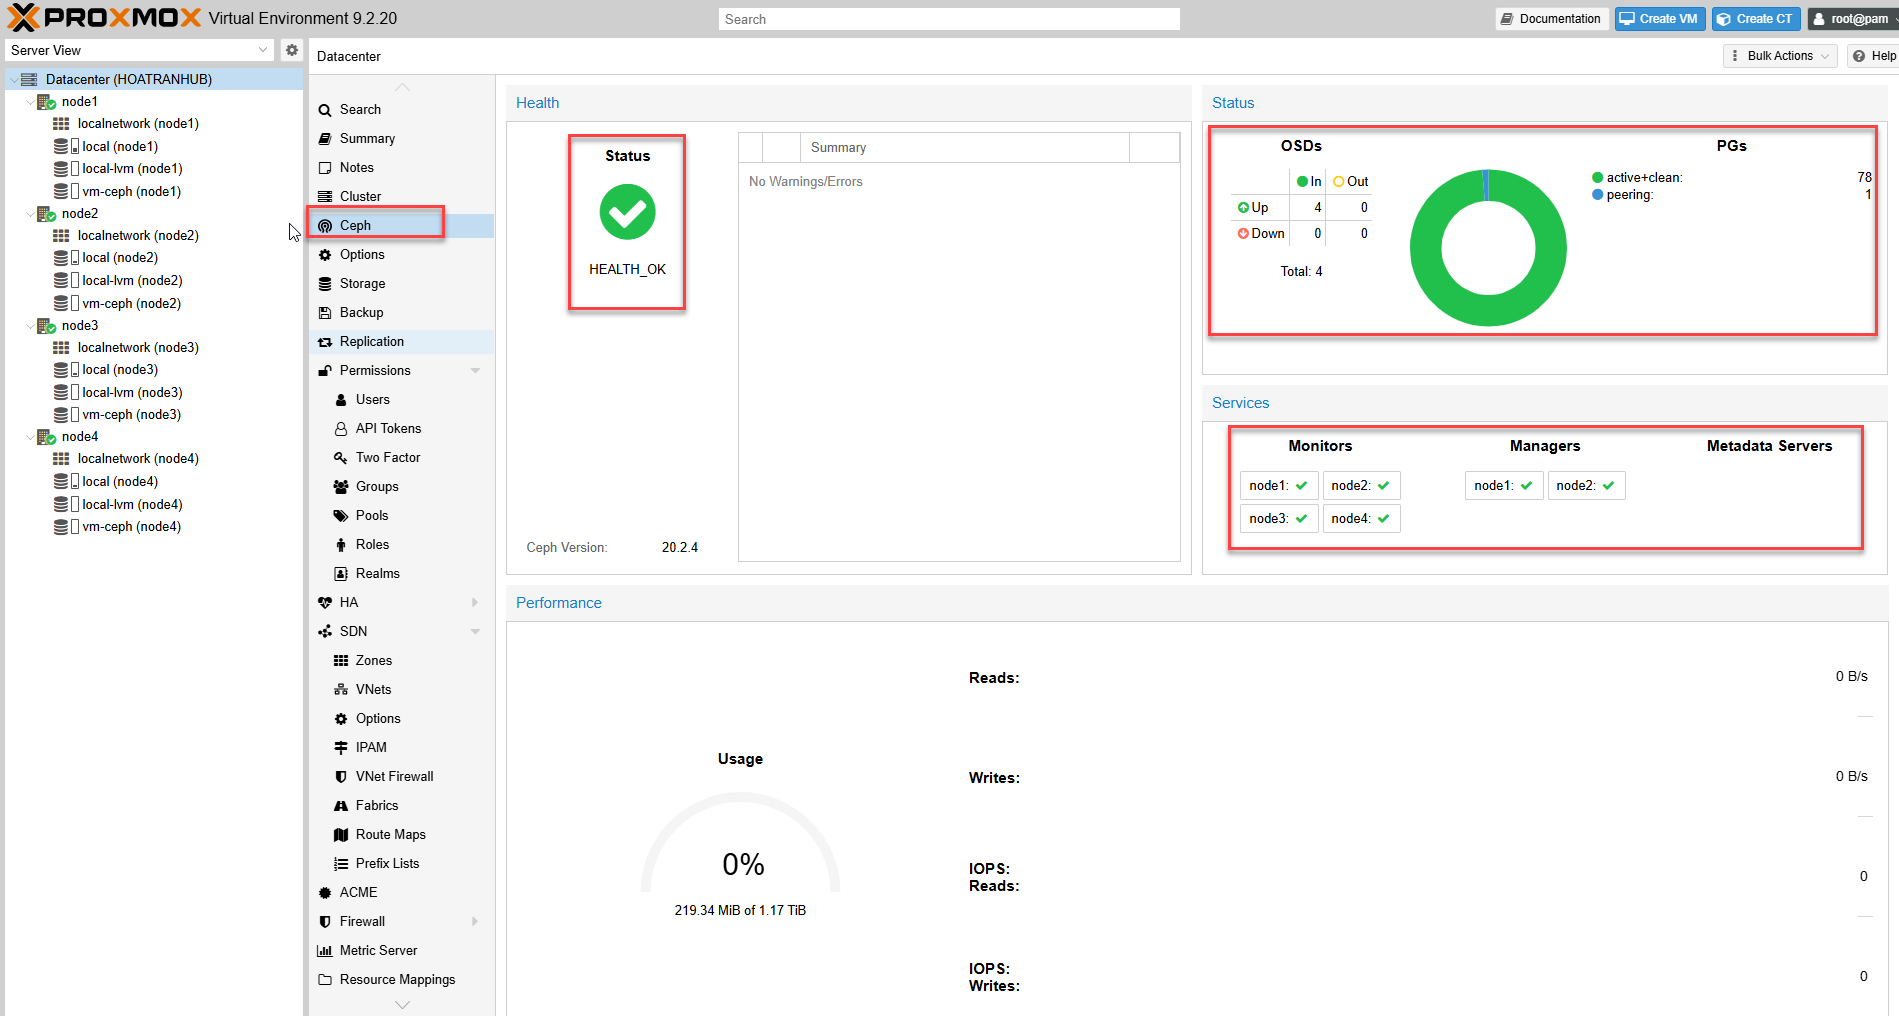
20.2.4, OSDs: 4 Up / 0 Down, Monitors node1–node4 ✓, Managers node1 + node2 ✓, PGs 78 active+clean. Usage 219.34 MiB / 1.17 TiB.
pool create; lần chạy thứ hai (sau khi mkdir /var/lib/ceph/mgr) đều OK. Thấy dòng đỏ trong lịch sử task là bình thường, miễn có dòng OK ngay sau đó.
Bật High Availability cho VM
Watchdog softdog · HA resource · Node-affinity rule · Test failover
pvecm status → Quorum OK (4 node) và ceph status → HEALTH_OK. HA Manager đảm bảo VM tự migrate khi node down; Ceph đảm bảo data không mất. Cần cả hai.
7.1 Kích hoạt watchdog trên cả 4 node
# Chạy trên TẤT CẢ 4 node:
echo "softdog" >> /etc/modules
modprobe softdog

# Kích hoạt watchdog cho pve-ha-lrm:
echo 'WATCHDOG_MODULE=softdog' >> /etc/default/pve-ha-manager
systemctl restart pve-ha-lrm

# Verify:
lsmod | grep softdog   # → softdog ...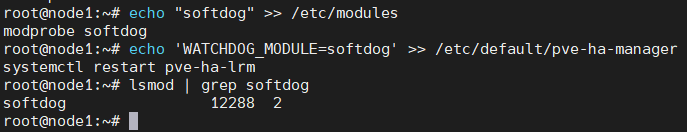
lsmod | grep softdog trả về softdog 12288 2 — module đã nạp và đang được dùng.
7.2 Thêm VM vào HA và tạo node-affinity rule
--resources là bắt buộc — rule mới phải gắn với VM cụ thể ngay lúc tạo. Tạo rule trước khi có VM sẽ báo 400 Parameter verification failed.
Bước 1 — add VM vào HA trước (ví dụ VMID 100):
ha-manager add vm:100 --state started --max_restart 2 --max_relocate 1Bước 2 — tạo rule kèm VM:
pvesh create /cluster/ha/rules \
    --rule ha-node-affinity \
    --type node-affinity \
    --nodes "node1:2,node2:2,node3:1,node4:1" \
    --affinity positive \
    --strict 0 \
    --resources "vm:100"

# Verify:
pvesh get /cluster/ha/rules
ha-manager status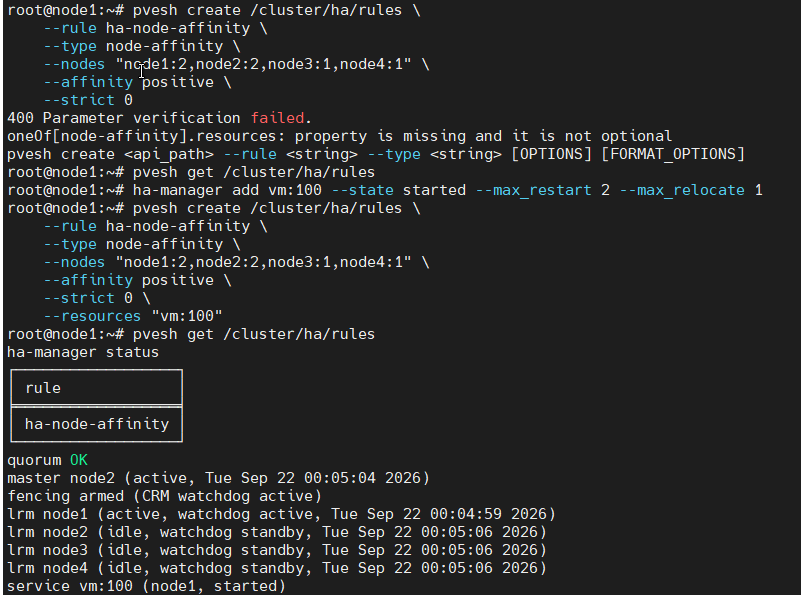
--resources → 400 Parameter verification failed … resources: property is missing. Sau khi ha-manager add vm:100 rồi tạo lại rule kèm --resources "vm:100" thì thành công. ha-manager status: quorum OK, master node2, fencing armed (CRM watchdog active), lrm node1 active, node2–4 idle/standby, service vm:100 (node1, started).
7.3 Thêm VM mới vào rule đã có
Mỗi VM mới chỉ cần 2 lệnh, không cần tạo lại rule — rule node-affinity dùng chung mãi:
# 1. Add VM 101 vào HA:
ha-manager add vm:101 --state started --max_restart 2 --max_relocate 1

# 2. Thêm VM 101 vào rule đã có:
pvesh set /cluster/ha/rules/ha-node-affinity \
    --resources "vm:100,vm:101"
7.4 Ý nghĩa priority và luồng failover
| Tham số | Giá trị | Ý nghĩa |
|---|---|---|
| node1:2, node2:2 | priority 2 | VM ưu tiên chạy trên node1 hoặc node2 trước |
| node3:1, node4:1 | priority 1 | VM chỉ chạy trên node3/4 khi node1 + node2 đều down |
| --strict 0 | không giới hạn | VM migrate ra ngoài danh sách node được nếu cần → an toàn hơn. 1 = chỉ chạy trong danh sách; cả nhóm down thì VM không start |
| --affinity positive | bám theo node | VM ưu tiên bám các node trong danh sách theo priority; khi node ưu tiên cao phục hồi, VM tự quay về |
Bình thường   : VM chạy trên node1 hoặc node2   (priority 2)
node1 down    : VM tự migrate sang node2        (cùng priority 2)
node1+2 down  : VM tự migrate sang node3/4      (priority 1)
node1 phục hồi: VM tự quay về node1             (priority cao hơn)
7.5 Test HA — tắt 1 node, theo dõi migration
# Mở terminal ping liên tục vào IP của VM TRƯỚC khi test:
ping -t <IP_VM>   # Windows — đo downtime

# Trên node1: shutdown graceful
shutdown -h now

# Theo dõi từ node2 (node còn sống):
watch -n2 "ha-manager status; echo; ceph status | grep -E '(health|osd|mon)'"

# Kết quả mong đợi:
# - VM tự migrate sang node khác trong vòng 30-60s
# - ceph status → HEALTH_WARN (do OSD của node1 down) nhưng IO tiếp tục
# - Khi node1 boot lại → OSD tự join, ceph status → HEALTH_OK
7.6 Mở rộng storage — thêm OSD /dev/sdc (tùy chọn)
/dev/sdc là HDD 250 GB: một tầng riêng, không phải thêm chỗ cho vm-ceph. Thứ tự bắt buộc: (1) kiểm class của OSD SSD là ssd (ceph osd tree, ceph osd crush class ls); (2) tạo rule-ssd/rule-hdd và gắn rule-ssd cho vm-ceph (cả .mgr), chờ active+clean; (3) mới thêm OSD HDD bằng lệnh bên dưới; (4) tạo pool vm-bulk với rule-hdd. Làm ngược thì dữ liệu VM tràn lên HDD rồi phải chuyển lại. Lệnh đầy đủ ở bài 07 mục 8.5. Chỉ muốn thêm chỗ cho tầng SSD (thêm đĩa SSD) thì dùng --crush-device-class ssd và không cần rule mới.
ceph status = HEALTH_OK. Làm từng node, đợi rebalance xong rồi mới sang node tiếp — không làm song song.
# Lặp lại cho node1 → node2 → node3 → node4

# 1. Verify disk mới sạch:
lsblk /dev/sdc   # → FSTYPE và MOUNTPOINT trống

# 2. Wipe phòng ngừa:
wipefs -a /dev/sdc && sgdisk --zap-all /dev/sdc
dd if=/dev/zero of=/dev/sdc bs=1M count=10 2>/dev/null

# 3. Tạo OSD, khai class tường minh (đĩa HDD → hdd; nếu /dev/sdc là SSD thì dùng ssd):
pveceph osd create /dev/sdc --crush-device-class hdd

# 4. Theo dõi rebalance (Ctrl+C để dừng):
watch -n5 "ceph -s | grep -E '(health|osd|pgs|usage)'"
# Đợi đến khi không còn "remapped" → sang node tiếp theo

# 5. Sau khi xong tất cả:
ceph osd tree      # → 8 OSD, toàn bộ up; CLASS = ssd (4 OSD /dev/sdb) và hdd (4 OSD /dev/sdc)
ceph osd crush class ls   # → [ "hdd", "ssd" ]
ceph status        # → HEALTH_OK, ~1.6 TiB raw (745 GiB SSD + 931 GiB HDD)
7.7 Fix lỗi mở console VM từ node khác
Triệu chứng: VM 100 đang chạy trên node1, mở console từ GUI của node2 thì báo lỗi vncproxy failed. Nguyên nhân: Proxmox cần SSH từ node2 → node1 để tunnel VNC, mà SSH key giữa các node đang lỗi.
rm -f /root/.ssh/id_rsa /root/.ssh/id_rsa.pub
ssh-keygen -t rsa -b 4096 -f /root/.ssh/id_rsa -N ""
pvecm updatecerts --force
systemctl restart pvedaemon pveproxy
Reset sạch môi trường Ceph (khi cần cài lại)
6 bước dọn dẹp · Chạy theo thứ tự node4 → node3 → node2 → node1
/etc/pve/ceph.conf).
C.1 — Stop và disable services
systemctl stop ceph-osd@* ceph-mon@* ceph-mgr@* ceph-mds@* 2>/dev/null || true
systemctl disable ceph-osd@* ceph-mon@* ceph-mgr@* 2>/dev/null || true
systemctl reset-failed 2>/dev/null || true
C.2 — Xóa LVM Ceph
for dm in $(dmsetup ls 2>/dev/null | grep ceph | awk '{print $1}'); do
  dmsetup remove --force "$dm" 2>/dev/null
done
for vg in $(vgs 2>/dev/null | grep ceph | awk '{print $1}'); do
  vgremove -f "$vg" 2>/dev/null
done
C.3 — Lazy unmount OSD directories
umount -l (lazy). KHÔNG dùng fuser -km — nó giết luôn cả tiến trình hệ thống và có thể làm node treo.
umount -l /var/lib/ceph/osd/ceph-* 2>/dev/null || true
umount -l /var/lib/ceph/osd/* 2>/dev/null || true
C.4 — Wipe disk OSD
# sdb = SSD OSD, sdc = HDD OSD (node nào không có HDD thì bỏ /dev/sdc)
for d in /dev/sdb /dev/sdc; do
  wipefs -a $d
  sgdisk --zap-all $d
  dd if=/dev/zero of=$d bs=1M count=10 2>/dev/null
done

# Verify:
lsblk /dev/sdb /dev/sdc   # → FSTYPE và MOUNTPOINT trống
C.5 — Force gỡ Ceph packages
# Fix apt trước nếu bị hỏng:
rm -f /etc/apt/sources.list.d/ceph.sources   # Xóa file deb822 lỗi
apt --fix-broken install -y 2>/dev/null

# Force purge:
DEBIAN_FRONTEND=noninteractive dpkg --purge --force-all \
    ceph-osd ceph-mon ceph-mgr ceph-mgr-modules-core \
    ceph-volume ceph-base ceph-common ceph ceph-mds ceph-fuse 2>&1
apt-get autoremove -y 2>/dev/null

# Verify sạch:
dpkg -l | grep ceph-osd   # → không còn dòng "ii" nào
C.6 — Xóa data và config còn sót
rm -rf /var/lib/ceph /var/log/ceph /etc/ceph/
rm -f /etc/pve/ceph.conf      # CHỈ TRÊN NODE1
find /etc/systemd/system -name "ceph*" -delete 2>/dev/null
systemctl daemon-reload

# Verify:
test -d /var/lib/ceph && echo "STILL_EXISTS — cần kiểm tra" || echo "GONE OK"
dpkg -l | grep -c "^ii.*ceph-osd" || echo "0 — OK"
Bài toán thực tế: chọn storage cho Proxmox
Ceph OSD vs Synology HA + Fiber Channel — phân tích chi phí, hiệu năng, HA
Phân tích workload hiện tại
| Tài nguyên | Yêu cầu (10 VM) | Có sẵn (3 server) | Nhận xét |
|---|---|---|---|
| vCPU | 80 vCPU | 96 thread (16C×2HT×3) | 0.83× — OK, không overcommit |
| RAM | 40 GB | 192 GB | 21% — thoải mái, dư nhiều |
| Storage | 1,000 GB usable | 0 GB (RAID1 dùng cho OS) | THIẾU — phải đầu tư thêm |
Ceph OSD không cần RAID trên disk OSD
| Đặc điểm | Ceph OSD | RAID truyền thống |
|---|---|---|
| Bảo vệ data | 3× software replication (Ceph tự quản lý) | Hardware RAID1/5/6 |
| Disk cần/server | 1 disk OSD raw — không cần RAID controller | 2 disk minimum (RAID1) |
| Quản lý | Ceph tự heal, tự rebalance khi OSD die | RAID controller phần cứng |
| Chi phí disk | 3 disk cho 3 node (1/node) | 6 disk cho 3 node (2/node) |
Tính toán disk cần mua
10 VM × 100 GB = 1 TB usable, replication 3×:
| Cấu hình OSD | Raw/server | Total raw (3 node) | Usable (÷3) | Phù hợp? |
|---|---|---|---|---|
| 1× 1TB SSD/server | 1 TB | 3 TB | ~1 TB | ✅ Vừa đủ |
| 2× 1TB SSD/server | 2 TB | 6 TB | ~2 TB | ✅ Tốt, có headroom |
| 1× 2TB NVMe/server | 2 TB | 6 TB | ~2 TB | ✅ Performance cao |
Bảng so sánh toàn diện
| Tiêu chí | Ceph OSD (thêm disk vào server) | Synology HA + Fiber Channel |
|---|---|---|
| Chi phí đầu tư thêm | 3–9 triệu (3× 1TB SSD) | 80–200 triệu (2 NAS HA + FC switch + 3× HBA) |
| Thời gian triển khai | 1–2 ngày | 3–7 ngày (FC zoning phức tạp) |
| TCO 3 năm | Thấp — ~10–20 triệu total | Cao — 100–250 triệu + bảo trì hằng năm |
| Latency | 1–3 ms (NVMe OSD: <1 ms) | FC: 0.1–0.3 ms / NFS 10GbE: 1–2 ms |
| IOPS | 50K–200K (scale tuyến tính theo số OSD) | FC: 500K+ / NFS 10GbE: 100K–200K |
| Throughput | 1–3 GB/s (aggregate cluster) | FC 16G: 1.6 GB/s/port; multi-port cao hơn |
| Storage usable | ~1–2 TB (tuỳ OSD chọn) | Tuỳ NAS model: 4–40 TB+ |
| HA khi 1 PVE node die | ✅ VM migrate tự động, 2 replica còn | ✅ VM migrate, NAS serve qua VIP |
| HA khi 1 OSD/disk die | ✅ Ceph tự rebalance, zero downtime | ✅ SHA VIP failover ~60s |
| HA khi toàn bộ storage die | ✅ Không ảnh hưởng (distributed 3 node) | ⚠️ Cả cụm NAS chết → downtime |
| RPO | ~0 (3× replication đồng bộ) | ~0 (SHA mirror real-time) |
| RTO khi storage fail | ~giây (Ceph tự route, không đợi failover) | ~60s (VIP failover NAS-1 → NAS-2) |
| Yêu cầu mạng | ⚠️ Cần 2 network riêng: NIC1 = public (VM), NIC2 = cluster (replication) | ✅ Đơn giản hơn: NIC1 = mgmt/VM, NIC2 = FC/storage |
| Giao thức storage | Ceph RBD (native, tối ưu) | Fiber Channel iSCSI hoặc NFS over FC |
| Scale-out storage | ✅ Thêm server/OSD → pool tự mở rộng | ⚠️ Giới hạn bởi slot NAS phần cứng |
| Scale-out compute | ✅ Thêm node PVE → tự join Ceph cluster | ✅ Thêm server mount FC/NFS thêm |
| Phức tạp setup | ⭐⭐⭐ Cao — CRUSH map, OSD, PG tuning | ⭐⭐⭐⭐ Rất cao — FC zoning, multipath, NAS admin |
| Vận hành hàng ngày | ⭐⭐⭐ Cần hiểu Ceph health, rebalancing | ⭐⭐ GUI DSM quen thuộc; FC cần chuyên gia riêng |
| Vendor lock-in | ✅ Không — open source hoàn toàn | ⚠️ Phụ thuộc Synology + FC vendor |
| Phù hợp 10 VM văn phòng | ✅ Đủ, tối ưu chi phí | ⚠️ Overkill về hiệu năng lẫn chi phí |
Ma trận quyết định theo nhu cầu
| Nhu cầu / Tình huống | Ceph OSD | Synology HA + FC |
|---|---|---|
| Budget eo hẹp (<20 triệu) | ✅ Chọn Ceph | ❌ Không phù hợp |
| 10 VM thông thường (ERP, web, email, CSDL vừa) | ✅ Đủ, tối ưu | ⚠️ Overkill |
| Cần >500K IOPS / latency <0.5 ms bắt buộc | ⚠️ Cần NVMe OSD | ✅ FC phù hợp |
| Kế hoạch scale 30–50 VM trong 2 năm | ✅ Thêm server/OSD dễ | ⚠️ NAS có giới hạn slot |
| Không có IT chuyên sâu về storage | ⚠️ Học Ceph ~1–2 tuần | ✅ GUI Synology trực quan |
| Không muốn phụ thuộc vendor | ✅ Open source hoàn toàn | ❌ Lock-in Synology + FC |
| Đã có FC switch/infrastructure sẵn | — | ✅ Tận dụng ngay |
| Oracle RAC / SQL Server AlwaysOn (I/O nặng) | ⚠️ NVMe OSD ổn | ✅ FC tối ưu nhất |
Kết luận và khuyến nghị dài hạn
| Giai đoạn | Hành động khuyến nghị | Lý do |
|---|---|---|
| Giai đoạn 1 Hiện tại — 10 VM | Ceph OSD: mua 3× 1TB SSD NVMe. Chi phí ~9–15 triệu | Đủ 1TB usable, không cần FC, scale tốt, TCO thấp nhất |
| Giai đoạn 2 Scale 30–50 VM | Thêm OSD disk hoặc thêm node PVE vào Ceph cluster | Không cần thay kiến trúc, pool tự mở rộng tuyến tính |
| Xét FC SAN khi nào | Oracle RAC, SQL Server AlwaysOn · Latency <0.5 ms bắt buộc từ ứng dụng · Có nhân sự Storage Admin chuyên biệt | FC chỉ hợp lý cho I/O-intensive database, không phải VM văn phòng |
Kiểm tra & xử lý lỗi thường gặp
Checklist CLI/GUI sau triển khai và các lỗi hay gặp nhất
Kiểm tra nhanh bằng CLI (node1)
# Tổng quan:
ceph status

# Chi tiết OSD:
ceph osd tree

# Pool stats:
ceph osd pool stats vm-ceph

# HA status:
ha-manager status

# Storage PVE:
pvesm status
Kiểm tra qua GUI Proxmox
Datacenter → Ceph → Status
  Health    : HEALTH_OK  (badge xanh lá)
  OSDs      : 4 osds: 4 up, 4 in
  Monitors  : node1, node2, node3, node4
  MGR       : node1 (active), node2 (standby)

Datacenter → Ceph → OSD
  4 dòng: osd.0/1/2/3 — Status = up, Class = ssd (khai ở mục 5.7), Host = nodeX

Datacenter → Ceph → Monitor
  Các dòng node1…node4 — Quorum = Yes

Datacenter → Ceph → Pools
  vm-ceph — Size=3 / Min=2, PGs active+clean

Datacenter → Storage
  vm-ceph  rbd  active  ~235 GiB available
Checklist tổng hợp sau triển khai
-
pvecm status→ 4 node, Quorum OK -
ceph status→ HEALTH_OK -
mon:đủ daemon, quorum có tên tất cả node đã tạo MON -
mgr:node1(active), standbys: node2 -
osd:4 osds: 4 up, 4 in, ~745 GiB raw -
pvesm status→vm-ceph rbd active - GUI: Ceph → Status = HEALTH_OK (xanh lá)
- GUI: OSD tab — 4 OSDs, tất cả up + in
- GUI: Monitor tab — Quorum = Yes
- Tạo thử 1 VM → disk trên
vm-ceph→ VM boot bình thường -
lsmod | grep softdogcó kết quả trên cả 4 node -
ha-manager status→service vm:XXX started nodeX, fencing armed - Test shutdown 1 node → VM tự migrate < 60s
- Node phục hồi → OSD join lại, cluster về HEALTH_OK
pveceph init không tự thêm mon_host vào /etc/pve/ceph.conf. Thêm tay:
Thư mục /var/lib/ceph/mgr/ chưa được tạo. Chạy trước:
PVE 9 bắt buộc --resources khi tạo HA rule. Phải ha-manager add vm:<VMID> trước, rồi mới tạo rule kèm --resources "vm:<VMID>". Xem lại mục 7.2.
Repo Ceph enterprise cần subscription. Script ở Bước 4 tự phát hiện và vô hiệu hóa repo này, đồng thời tạo file /etc/apt/sources.list.d/ceph.sources trỏ sang ceph-tentacle no-subscription.
- Kiểm tra
getent hosts node1 node2 node3 node4— mỗi tên phải trả đúng 1 IP - Node sắp join phải chưa có VM/CT nào — join sẽ xóa
/etc/pvecủa node đó - Thời gian giữa các node phải đồng bộ:
timedatectl - Mất WebUI sau khi join là bình thường — đăng nhập lại, đừng bấm Join lần hai
Disk còn partition / filesystem / LVM cũ. Wipe đúng disk bị báo lỗi (sdb = SSD, sdc = HDD; ví dụ dưới là sdb, với sdc thì thay tên disk):
SSH key giữa các node bị lỗi. Chạy 4 lệnh ở mục 7.7 để sinh lại key và cập nhật certificate.
Không. OSD của node đó down nên Ceph báo WARN, nhưng vì min_size=2 nên IO vẫn tiếp tục. Khi node boot lại, OSD tự join và cluster quay về HEALTH_OK. Chỉ lo khi WARN kéo dài sau lúc node đã online — kiểm tra systemctl status ceph-osd@<id>.